Mostrando postagens com marcador PERFORMANCE. Mostrar todas as postagens

sábado, 26 de abril de 2025

BigQuery - Inserindo 1 milhão de registros em segundos (Google Cloud Plataform).

    Neste estudo de caso do blog, demonstraremos o INSERT de arquivos JSON em Tabelas BigQuery.

Milhões de registros (direto de arquivos físicos heim, acredite rs) em questões de Segundos;


Existem outros cenários, de maior preformance que abordaremos nos proximos post; como exemplos Datasets públicos sendo migrados e copiados em décimos de segundo...


  • NYC Taxi Fares +/- 36 milhoes de registros disponiveis de tarifas dos taxis americanos (bigquery-public-data.new_york_taxi_trips.tlc_yellow_trips_2022)

  • Wikipedia the massive database; como eles mesmo se apresentam "Um gigantesco" Database, que inclui dados de tráfego de cada página da Wikipedia (bigquery-public-data.wikipedia.pageviews_2023)

*  FILTRO / (Partition elimination) Aproximadamente 4,4 bilhoes de registros; em Um (1) Unico mês, 30 Dias rs;


** Cuidado: LEMBRAMOS  QUE  CONSUMO (QUERY) ACIMA DE 1 TB (um terabyte) MÊS / SERÁ COBRADO ADICIONAL; FIQUE ATENTO, rs ...


Para a preparação, vamos criar um arquivo de texto com 1 milhão de linhas em formato JSON, utilizando um script automático em Python.

Primeira Etapa 1)

Faremos uma abordagem mais simples: ler o arquivo de texto/JSON linha por linha e inserir na mesma tabela do BigQuery, uma de cada vez. Segundo a documentação do BigQuery Streaming Insert, é possível inserir várias linhas em uma única chamada da API.

https://cloud.google.com/bigquery/docs/streaming-data-into-bigquery


Neste diagrama, existem três componentes principais:

  1. File Reader: Realiza a leitura simples de arquivos de texto, encaminhando o conteúdo (linhas) para o Canal.

  2. Canal (c1 e c2): Responsável por compartilhar os dados em formato de cadeia de caracteres de texto. Ele prepara e envia o buffer de strings.

  3. Work: Responsável por inserir os dados em uma tabela do BigQuery.

Channel é uma estrutura nativa da linguagem Go, utilizada para comunicar e sincronizar co-rotinas (goroutines).
Eu gosto de assimilar o conceito de channel a threads da CPU, embora não sejam gerenciadas pelo sistema operacional. Eles não bloqueiam nem interferem nas threads do sistema operacional, tornando a execução mais eficiente.

Os canais são bi-direcionais, permitindo a passagem de dados. Quando concluído, o conteúdo segue através do pipe para o Worker.

Para a terceira e última etapa, utilizaremos a goroutine do Go. O Go permite a sincronização de milhares ou até milhões de goroutines em execução paralela. Essas execuções simultâneas são significativamente mais rápidas do que outras formas de agendamento, já que as goroutines são muito leves (cerca de 2 KB de stack cada, podendo crescer conforme necessário).

Para decidir o número máximo de buffers e workers, é importante entender as cotas e os limites da API BigQuery Streaming, conforme descrito na documentação:

Cotas e limites  |  BigQuery  |  Google Cloud


Usando a configuração mais alta

Conseguimos inserir (1) um milhão de linhas em apenas 14 segundos!


Conclusão

Neste caso de teste do blog, aprendemos a aplicar os conceitos de simultaneidade e goroutines para fazer com que nossos "Jobs" (INSERT) aproveitem ao máximo os recursos da tecnologia BigQuery, executando tarefas simultâneas de forma incrivelmente mais rápida.

Evidências:


sexta-feira, 10 de janeiro de 2025

Performance extrema, com DynamoDB (DAX) Accelerator

 O Amazon DynamoDB foi concebido para escala e performance. Na maioria dos casos, os tempos de resposta do DynamoDB podem ser medidos em milissegundos de um dígito. No entanto, existem certos casos de uso que exigem tempos de resposta em microssegundos. Para esses casos de uso, o DynamoDB Accelerator (DAX) oferece tempos de resposta rápidos para acessar dados finais consistentes.


DynamoDB (DAX) Cluster


O DAX é um serviço de armazenamento em cache compatível com o DynamoDB no qual você pode se beneficiar da rápida performance em memória para aplicações exigentes. O DAX lida com três cenários principais:

  1. Como um cache na memória, o DAX reduz os tempos de resposta de workloads de leitura final consistente por uma ordem de magnitude que varia de milissegundos de um único dígito até microssegundos.

  2. O DAX reduz a complexidade operacional e da aplicação fornecendo um serviço gerenciado que é compatível com a API do DynamoDB. Portanto, ele exige apenas alterações funcionais mínimas para uso com um aplicativo existente.

  3. Para workloads de leitura intermitentes ou pesadas, o DAX fornece throughput mais alto e economia potencial de custos operacionais reduzindo a necessidade de provisionar unidades de capacidade de leitura em excesso. Isso é especialmente benéfico para aplicativos que exigem leituras repetidas para chaves individuais.

O DAX é compatível com a criptografia do lado do servidor. Com a criptografia em repouso, os dados persistentes pelo DAX no disco serão criptografados. O DAX grava dados ao disco como parte das alterações de propagação do nó primário para as réplicas de leitura. 

O DAX também oferece suporte à criptografia em trânsito, garantindo que todas as solicitações e respostas entre a aplicação e o cluster sejam criptografadas por TLS (Transport Level Security) e que as conexões com o cluster possam ser autenticadas pela verificação de um certificado de cluster. .


O DAX dá acesso a dados finais consistentes de tabelas do DynamoDB, com latência de microssegundos. Um cluster do DAX multi-AZ pode servir milhões de solicitações por segundo.

O DAX é ideal para os seguintes tipos de aplicações:

  • Aplicativos que exigem o melhor tempo de resposta possível para leituras. Alguns exemplos incluem lances em tempo real, jogos sociais e aplicações de negócios. O DAX oferece uma performance de leitura rápida na memória para esses casos de uso.

  • Aplicativos que fazem a leitura de um pequeno número de itens com mais frequência do que outros. Por exemplo, considere um sistema de comércio eletrônico que tem uma promoção de um produto popular válida por apenas um dia. Durante a promoção, a demanda por esse produto (e seus dados no DynamoDB) aumentaria drasticamente em comparação a todos os outros produtos. Para mitigar os impactos de uma chave de "aceleração" e uma distribuição de tráfego não uniforme, você pode descarregar as atividades de leitura em um cache do DAX até que essa promoção de um dia acabe.

  • Aplicativos que exigem leitura intensa, mas que também são sensíveis aos custos. Com o DynamoDB, você fornece o número de leituras por segundo que a sua aplicação exige. Se as atividades de leitura aumentarem, você poderá aumentar o throughput de leitura provisionado das suas tabelas (a um custo adicional). Como alternativa, é possível descarregar as atividades da sua aplicação em um cluster do DAX e reduzir a quantidade de unidades de capacidade de leitura que você precisa comprar.

  • Aplicativos que exigem leituras repetidas em um grande conjunto de dados. Esses aplicativos poderiam desviar os recursos de banco de dados de outros aplicativos. Por exemplo, uma análise de longa execução de dados meteorológicos regionais pode consumir toda a capacidade de leitura em uma tabela do DynamoDB. Essa situação pode afetar negativamente outros aplicativos que precisam acessar os mesmos dados. Com o DAX, a análise meteorológica pode ser realizada com base nos dados em cache.

O DAX não é ideal para os seguintes tipos de aplicação:

  • Aplicativos que exigem leituras fortemente consistentes (ou que não toleram leituras eventualmente consistentes).

  • Aplicativos que não precisam de tempos de resposta em microssegundos para leituras ou descarregar atividades de leitura repetidas de tabelas subjacentes.

  • Aplicações que exigem alto volume de gravações. O alto volume de gravações leva ao aumento da replicação entre nós do DAX em um cluster. Isso causa um aumento no consumo de recursos e no risco de problemas de disponibilidade.

  • Aplicações sem muitas leituras repetidas. O DAX tem melhor desempenho quando as taxas de acertos de cache excedem 90%. Taxas de acertos de cache mais baixas aumentam as perdas no cache, o que consome mais recursos em todo o cluster do DAX.

segunda-feira, 17 de julho de 2023

Impacto da Alteração do Nível de Compatibilidade no Cache - SQL Server

        No mundo do SQL Server, o nível de compatibilidade do banco de dados desempenha um papel vital na determinação de como um banco de dados se comporta quando se trata de executar consultas e otimizar planos de execução. O SQL Server se esforça constantemente para melhorar o desempenho e a otimização de consultas, adotando novos algoritmos e aprimoramentos a cada novo lançamento. Como resultado, alterar o nível de compatibilidade torna-se necessário para aproveitar os recursos e melhorias mais recentes. Nesta postagem do blog, exploraremos como a alteração do nível de compatibilidade afeta o cache de consulta e por que é essencial estar ciente de seu impacto. 


Compreendendo o cache de consulta

      Antes de aprofundar nos efeitos da alteração do nível de compatibilidade, vamos discutir brevemente o cache de consulta no SQL Server. O cache de consulta, também conhecido como cache de plano, armazena os planos de execução gerados pelo otimizador de consulta do SQL Server. Quando uma consulta é executada, o SQL Server primeiro verifica o cache para ver se existe um plano de execução para essa consulta específica. Se encontrado, o plano em cache é usado, economizando a sobrecarga de gerar um novo plano. Isso melhora significativamente o desempenho da consulta e reduz o tempo de processamento da consulta.


Verificando o status do cache: 

-- Check the buffer cache usage
SELECT
    COUNT(*) AS CachedPagesCount,
    COUNT(*) * 8 / 1024 AS CachedSizeMB
FROM sys.dm_os_buffer_descriptors
WHERE database_id = DB_ID();
GO
-- Check the plan cache usage
SELECT
    objtype AS CacheObjectType,
    COUNT(*) AS CachedPlansCount,
    SUM(size_in_bytes) / 1024 AS CachedSizeKB
FROM sys.dm_exec_cached_plans
GROUP BY objtype;
GO
-- Check the procedure cache usage
SELECT
    cacheobjtype AS CacheObjectType,
    COUNT(*) AS CachedObjectsCount
FROM sys.dm_exec_cached_plans
GROUP BY cacheobjtype;
GO

-- For SQL Server 2008:
ALTER DATABASE [Banco_Homolog] SET COMPATIBILITY_LEVEL = 100;
Aqui, 100 significa SQL Server 2008. Se você deseja alterar o nível de compatibilidade para SQL Server 2022, pode usar 160 em vez de 100. Da mesma forma, pode usar 140 para SQL Server 2017.

Depois de alterar o nível de compatibilidade e verificar o cache de consulta novamente, 

você verá que ele está quase vazio.


Em conclusão, o nível de compatibilidade de um banco de dados SQL Server desempenha um papel crucial na determinação do comportamento e desempenho da otimização de consulta. Alterar o nível de compatibilidade pode influenciar os planos de execução em cache e, por sua vez, afetar o desempenho geral da consulta. Como parte da verificação abrangente de integridade do desempenho do banco de dados , sempre considero o nível de compatibilidade do banco de dados para garantir que os clientes aproveitem todo o potencial de seus bancos de dados SQL Server.

referencias Pinal Dave: comprehensive-database-performance-health-check

Grande abraços

Gustavo Damatto

MCSD - Microsoft Certified Solutions Developer


linkedin.com/in/damatto

Ribeirão Preto-SP


sexta-feira, 26 de junho de 2020

SQL SERVER - Dicas que todo DEV deveria conhecer part-5

Nesta sequencia de tópicos abordaremos algumas dicas, que todo desenvolvedor deveria ter a oportunidade de conhecer. Todo desenvolvedor que programa em T/SQL, precisa estar atento a algumas "tips" do SQL Server que podem facilitar em seu dia-a-dia na empresa.

Dicas part-1 Transaction Log
Dicas part-2 Variáveis ​​table e JOIN's & Criação de tabelas dentro de stored procedures
Dicas part-3 Keywords performance
Dicas part-4 Ad Hoc Queries (Forced Parameteeterization)


Parte 5 - SET DEADLOCK_PRIORITY

Evite deadlock's para transações mais importantes, com a mínima alteração de código.

Hoje vamos aprender hoje como reduzir o impasse em transações importantes, com a mínima alteração de código. O requisito, não importa o que aconteça, não desejamos que essa transação entre em conflito (bloqueio). Outro requisito importante é, que não podemos alterar a regra de negocio, modificações profundas no código do sistema, sem compreender a lógica de negócios.

Nosso primeiro objetivo é, entender o que está criando o deadlock?
Depois de investigar, sempre descobrimos concorrências simultâneas em uma ou mais tabelas especificas.

De fato, a melhor solução é SEMPRE é reescrever o código para que não exista o deadlock,
mas nem sempre é possível como uma solução imediata.

Isso nos leva a apenas uma solução rápida; Definir a prioridade do deadlock.


1
SET DEADLOCK_PRIORITY HIGH;


Esta instrução quando "setada", especifica a real importância da sessão atual.

Se a sessão estiver em conflito com outra transação. Esta declaração SET certifica-se de que
a transação importante deste conteudo, não entrará em deadlock, porem as outras transações ficam em espera com uma maior frequência.

Neste cenário, o hint descrito nesta postagem reduziu o impasse para a transação importante,
mas não reduziu o número total do bloqueios. Portanto, use a técnica somentos nos casos extremamente especiais, quando não é possivel alteração de codigo, conforme detalhamos anteriormente.

Curiosidade:

  • Se ambas as sessões tiverem a mesma prioridade de deadlock, a instância do SQL Server escolhe a sessão que é menos dispendiosa para ser revertida como a vítima de deadlock. Por exemplo, se ambas as sessões tiverem definido sua prioridade de deadlock como HIGH, a instância escolherá como uma vítima a sessão que calcula ser menos dispendiosa para reverter. O custo é determinado comparando o número de bytes de log gravados naquele ponto em cada transação.


Você usa deadlock priority na sua lógica de negócios?
Compartilhe sua experiência nos comentários.

Grande abraços

segunda-feira, 20 de janeiro de 2020

SQL SERVER - Dicas que todo DEV deveria conhecer part-4

    Nesta sequencia de tópicos abordaremos algumas dicas, que todo desenvolvedor deveria ter a oportunidade de conhecer. Todo desenvolvedor que programa em T/SQL, precisa estar atento a algumas "tips" do SQL Server em seu dia-a-dia na empresa.

Dicas part-1 Transaction Log
Dicas part-2 Variáveis ​​table e JOIN's & Criação de tabelas dentro de stored procedures
Dicas part-3 Keywords performance


Parte 4 - Ad Hoc Queries (Forced Parameterization)

Uma Consulta Ad Hoc é um tipo de consulta SQL em um banco de dados que é criada na hora,
no momento em que surge uma necessidade, a partir de um requisito específico.

Ad hoc é uma expressão em latim que significa “para este propósito“.  Ou seja, a consulta é criada apenas para satisfazer aquela necessidade específica, aquele propósito, em um momento específico.

(Que não seja generalista, Que não seja utilizável em mais de um caso) e que não é salva no cache do SGBD como por exemplo fazemos com estored procedures, funções ou scripts, para que sejam reutilizados posteriormente.


É interessante notar que em ambientes onde queries Ad Hoc representam um percentual considerável do workload total,  quantidade de compilações pode se tornar um problema, independente do tamanho do servidor.

O motivo é simples, o SQL Server, por padrão, produz diferentes planos de execução para cada query Ad Hoc

Por exemplo:

Query 1
SELECT ColunaA, ColunaB, ColunaC FROM Tabela WHERE ColunaA = 'X'

Aqui o SQL compilaria e guardaria no cache o plano de execução utilizado para encontrar registros onde o valor = X.

Query 2
SELECT ColunaA, ColunaB, ColunaC FROM Tabela WHERE ColunaA = 'Y'

Bem, numa execução parametrizada (Uma stored procedure, por exemplo), o SQL Server simplesmente poderia reutilizar o plano da primeira query já que a mudança foi mínima (apenas o valor utilizado no filtro), porém a engine relacional entende como uma nova query, ou seja,
durante o processo de otimização da query o Query Optmizer recebe um cache miss, que basicamente indica que não há um plano de execução existente para esta query e ele então é responsável por gerar e armazenar esse novo plano no cache, mesmo sendo praticamente igual ao plano anterior.

Quais opções eu tenho para diminuir o número de compilações?

Bem, se você acredita que a grande maioria das suas queries utilizam planos similares para serem executadas, Não faça o simplista SELECT * FROM puro, você poderia utilizar a opção system stored procedure sp_executesql. Quando utilizada, você está basicamente forçando a parametrização da query especifica.


** Por complexidade, estamos detalhando aos desenvolvedores apenas o Forced Parameterization, sem a necessidade de ativar o "optimize for ad hoc workloads" por Database, que ficaria sob responsabilidade mais detalhadas dos encarregados pela Base de dados (DBA's).

Por exemplo:
 EXECUTE sp_executesql  N'SELECT ColunaA, ColunaB, ColunaC FROM Tabela WHERE ColunaA = @valor', N'@valor varchar(1)', @valor = 'X'; 

Nesta execução, se observarmos o plano armazenado em cache seria algo mais ou menos assim:
SELECT ColunaA, ColunaB, ColunaC FROM Tabela WHERE ColunaA = @valor.

Ou seja, não há um valor específico armazenado junto ao plano, o que faz com que a próxima execução, independente do parâmetro utilizado, encontre um plano satisfatório já armazenado em cache.

Há uma pequena linha entre essa opção ser boa ou não para um determinado ambiente,
já que um plano pode ser realmente bom para várias queries e aí reduzir o número de compilações e consequentemente o tempo de CPU (e memória consumida) ou impactar várias das queries porque cada uma gosta de um plano específico tudo uma questão de Testar.

Boa sorte, uma reflexão por Jack Li;

"If things don’t work out, it’s easy to back it out. Over the course of troubleshooting performance issues, I have used this trick many times." Jack Li


Fique por dentro, e acompanhas essas e outras dicas aqui no blog.
Grande abraços a todos.

quinta-feira, 12 de dezembro de 2019

SQL SERVER - Dicas que todo DEV deveria conhecer part-3

    Nesta sequencia de tópicos abordaremos algumas dicas, que todo desenvolvedor deveria ter a oportunidade de conhecer. Todo desenvolvedor que programa em T/SQL, precisa estar atento a algumas "tips" do SQL Server em seu dia-a-dia na empresa.

Dicas part-1 Transaction Log
Dicas part-2 Variáveis ​​table e JOIN's & Criação de tabelas dentro de stored procedures


Part-3 Keywords que você deveria esquecer (ao menos evitar ao máximo) rs

SELECT * FROM – Evite asterisco, especifique as colunas necessárias, asterisco deve ser evitado pelo simples motivo de que é muito inútil retornar mais colunas do que o necessário, usando esse recurso. Pense no volume de dados, e aumento exponencial deste. Sendo retornados em toda chamada sem necessidade, é sobrecarregar a base de dados atoa. Outro problema é que, o interpretador SQL deve buscar no esquema da tabela as colunas que deveram de ser retornadas, antes de realizar a consulta propriamente dita.

IN – se você quer retornar os registros cujas condições são múltiplos identificadores, como todos os empregados cujos IDs sejam 1,3,7,45,100, você irá usar um IN, certo?


O problema aqui é que o IN é interpretado pelo motor de busca como uma junção de OR

Ou seja, WHERE ID IN (1,3,7,45,100)
é a mesma coisa que WHERE ID=1 OR ID=3 OR ID=7 OR ID=45 OR ID=100

Isto Não chega a ser um problema em uma consulta com poucas dezenas de valores no IN, mas tome cuidado quando você chega nas centenas deles. Já experimentamos outras abordagens com tabelas temporárias, tabelas em memória, entre outras, com resultados semelhantes. Por estes motivos muitos casos são mais eficientes tratamento na camada de aplicação e filtro, do que a sobrecarga no banco de dados fugindo do uso excessivo de IN.


Bônus: Dica rápida ...

Qual instrução é melhor para o desempenho - SELECT ou SET? SQL Server
Confere lá https://scriptsemsql.blogspot.com/2018/03/qual-e-melhor-para-o-desempenho-select.html

Fique por dentro, acompanhe essas e outras dicas aqui no blog.
Grande abraço.

terça-feira, 5 de novembro de 2019

SQL SERVER - Dicas que todo DEV deveria conhecer part-2

    Nesta sequencia de tópicos abordaremos algumas dicas, que todo desenvolvedor deveria ter a oportunidade de conhecer. Todo desenvolvedor que programa em T/SQL, precisa estar atento a algumas "tips" do SQL Server em seu dia-a-dia na empresa.


Part-2 Variáveis ​​table e JOIN's (DECLARE @table_variable_name TABLE)

Não use variáveis ​​de tabela em conjunto com JOIN. Use tabelas temporárias, CTEs (Common Table Expressions) em JOIN.


Embora as variáveis ​​table sejam muito rápidas e eficientes em muitas situações, o mecanismo do SQL Server a vê como uma única linha. Devido a isso, eles apresentam um desempenho horrível quando usados ​​em JOIN's. Tabelas temporárias apresentam melhor desempenho com JOIN's em comparação com as variáveis ​​da tabela.

Dica complementar: Criação de tabelas dentro de stored procedures? Cuidado!

Quando uma tabela é criada e utilizada dentro de uma mesma stored procedure, o otimizador não tem conhecimento das suas estatísticas, e assume que esta tabela tem 100 linhas e 10 páginas. Se a tabela criada é muito grande, esta suposição pode levar o otimizador a calcular um plano de acesso não otimizado / Errado. Para evitar este problema, crie a tabela em uma rotina anterior e utilize-a em outra.

Variáveis Locais ou Parâmetros na cláusula WHERE ? 

O otimizador não tem informações sobre o valor de uma variável, mas, em tempo de compilação, sabe o valor de um parâmetro. Isso posto, a utilização de parâmetros em cláusula where, leva o otimizador a produzir um plano de acesso mais eficiente.

mais recente, detalhamos esse hint no topico especifico: Dicas que todo DEV deveria conhecer
Parte 4 - Ad Hoc Queries (Forced Parameterization)

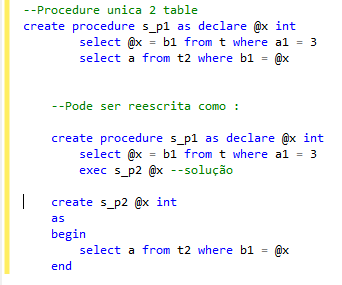
Exemplo sugestivo, observe que na primeira procedure

a Variavel @x recebe = b1 e logo em sequencia a variavel é passada como filtro WHERE b1 = @x
(O otimizador não tem informações sobre o valor de uma variável)

Na segunda procedure, em duas estapas: @x recebe = b1

Que é passado como parâmetro pra uma segunda procedure Exec s_p2 (@x) --solução
(Que força o otimizador a produzir um plano de acesso mais eficiente)

* Imagine no exemplo, uma tabela (t2) já criada anteriormente no escopo da procedure.

SQL SERVER - Dicas que todo DEV deveria conhecer part-1

    Nesta sequencia de tópicos abordaremos algumas dicas, que todo desenvolvedor deveria ter a oportunidade de conhecer. Todo desenvolvedor que programa em T/SQL, precisa estar atento a algumas "tips" do SQL Server em seu dia-a-dia na empresa.

Serão abordados diversos temas sequenciais, e depois da conclusão listaremos todos em um menu completo aqui.

Part-1 Transaction Log 
Part-2 Variáveis ​​table e JOIN's & Criação de tabelas dentro de stored procedures


Part-1 Transaction Log 

De modo simplista, todos imaginamos que quando executamos algum DML insert, update ou delete.
O SGBD registra em disco Transaction Log (faremos referencia com T-Log, daqui pra frente) para depois efetuar commit em mdf, certo?

Não - Errado.

Neste caminho simplificado, existe um camada de Log Buffer. Uma região em memoria responsável pelo buffer das informações, que somente apos check irá "commitar" esses dados em memoria para disco log. De maneira simplificada, esse é o WAIT mais comum relacionado ao T-Log.
Ele está relacionado ao tempo que SQL Server está esperando para escrever no disco.

Como podemos otimizar essa escrita ?

Nossa primeira Dica, neste tópico será a otimização do Transaction log, imaginem um loop de 10mil transações:

Já imaginou o trabalho que o SQL Server teria para abrir e fechar 10mil transações em loop?
Então imagine como seria muito mais simples, fazer tudo em uma única transação!

Padrão:
WHILE @id < 10000
   BEGIN
    INSERT INTO TABELA_TESTE VALUES(...)
   END

Melhoria:
BEGIN TRAN
   WHILE @id < 10000
   BEGIN
    INSERT INTO TABELA_TESTE VALUES(...)
   END
COMMIT

*
Por favor não confundam transaction begin tran  / while if begin de blocos de comando ok

Essa falha é muito comum em select into, update from também, onde indiferente da transação 
Já existiria um tratamento de erro no final If (@@Error > 0). O que torna totalmente adaptável o controle transacional no bloco de repetições.

No exemplo nosso tempo de execução baixou de forma considerável de mais de 2 minutos para 45 segundos! Ou seja, foi reduzido mais da metade do tempo! Essa melhora ocorreu por que o SQL Server processou as 10 mil inserções em uma única transação. Nem sempre é possível realizar essa otimização, mas ela pode ser uma boa solução.

quarta-feira, 25 de setembro de 2019

SQL Server - Pare de usar DBCC DBREINDEX & Use ALTER INDEX

Já faz mais de uma década que a instrução DBCC DBREINDEX foi descontinuado, no entanto, de vez em quando ainda os encontro em alguns clientes. Na semana passada, ao revisar o plano de manutenção de um dos clientes, notamos que eles ainda estão usando a sintaxe mais antiga, em vez de usar a nova sintaxe do ALTER INDEX.


Diga Não ao DBCC DBREINDEX


Microsoft sempre muito clara por anos que, se algum recurso é marcado como obsoleto e o recurso de substituição aparece, é preciso começar a planejar a transição. Realmente não faz sentido continuar usando o recurso que será removido pela equipe do produto nas futuras versões.

No entanto, geralmente recebo um pouco de resistência quando tentamos solicitar aos desenvolvedores ou analistas que usem um novo recurso, em vez do recurso que eles estão usando há muitos anos. Eu entendo totalmente a filosofia de Se não está quebrado, não conserte. 

Mas há muitos motivos para mudar do DBCC DBREINDEX e usar o ALTER INDEX. 
Estas são as três limitações principais do DBCC DBREINDEX.


  • Ele não suporta a opção de reconstrução online
  • Sem suporte para índices recuperáveis
  • Não há suporte para compactação de dados

Não é que ele não suporte apenas as três opções acima, mas muitos outros aprimoramentos desde o lançamento do SQL Server 2008.


Sintaxe do ALTER INDEX


Aqui está a sintaxe do índice ALTER INDEX Rebuilding.


1
ALTER INDEX IndexName ON TableName REBUILD;
É uma sintaxe muito simples. Aqui está outra sintaxe para reorganizar o índice.
1
ALTER INDEX IndexName ON TableName REORGANIZE;

Bem é isso. Esta ainda é a minha pergunta para você - você ainda usa o DBCC DBREINDEX
para recriar seus índices. Existe algum motivo específico para continuar usando o recurso
que foi marcado como obsoleto por tantos anos? Será útil saber o motivo de todos
e podemos compartilhar se você publicar sua resposta como um comentário do blog.
Grande abraços
Referência:  Pinal Dave